
第 25 篇那段虛擬碼裡,主代理每一輪自己決定要開幾張 delegate 單、每張寫什麼。節點有了,可是邊是臨場長出來的:同一個問題跑兩次,圖可能長得不一樣。
第 21 篇提過,從「一個模型在迴圈裡自己決定」走到「一張事先排好的圖」,Andrew Ng 把這個轉向叫做圖工程(graph engineering),第 25 篇開了頭。這一篇是它的本體:節點之間怎麼接、邊上傳什麼、哪裡有環。先講結論:Anthropic 整理的五種常見接法,選哪一種,看你事先知道多少。 其中只有一種在定義上就是一個環:一個寫、一個審。它有沒有用,看審的那一方手上有沒有寫的那一方沒有的東西。
Anthropic 的〈Building effective agents〉列了五種工作流程(2026-10-09 查)。第 21 篇引過它對工作流程和代理的分界,這次看它列的形狀,每一種都可以畫成節點和邊:
| 接法 | 畫成圖 | 什麼時候用(原文的條件) | 這個系列在哪看過 |
|---|---|---|---|
| 提示串接(prompt chaining) | A → B → C,每一步吃上一步的輸出 | 任務可以乾淨地拆成固定的幾步 | 第 21 篇講過的工作流程 |
| 路由(routing) | 條件邊:照輸入決定下一個節點 | 有明確不同的類別,分開處理比較好 | 第 24 篇的串接(cascade)目的相同,決定的時間點不同 |
| 平行(parallelization) | 一分多、多合一 | 子任務能同時做換速度,或需要多個角度、多次嘗試換更有把握的結果 | 第 25 篇講的平行 |
| 協調者與工作者(orchestrator-workers) | 一個中心節點臨場決定要分出哪些節點 | 複雜到無法事先預測需要哪些子任務 | 第 25 篇的研究系統 |
| 評估者與最佳化者(evaluator-optimizer) | 一個環:產出、評估,不過就繞回去,要有出口條件 | 有清楚的評估標準,而且反覆修改能帶來看得出來的進步 | 這一篇 |
這張表有兩條分界線。
第一條,邊是誰畫的。 前三種的邊是你事先寫在程式裡的,路由每次走哪一條會變,但能走的路就那幾條,這比較接近 Hu(2026)主張的明確控制流。第四種的子任務不是事先定好的,原文的說法是由協調者照輸入決定,所以第 25 篇那段程式每次跑出來的圖都可能不同。原文舉的例子是寫程式:要改幾個檔案、每個檔案怎麼改,通常要看任務才知道。你事先知道要拆成哪幾塊,就用前三種。不知道,才交給協調者。
第二條,有沒有環。 五種裡只有第五種,原文在定義裡就寫了「在一個迴圈裡」:一個產出、一個評估並給回饋,不過就再來。所以它嚴格說已經不是 DAG。前四種在原文裡沒有這樣描述,雖然實作上協調者也可能多派幾輪,第 25 篇的研究系統就會。第 22 篇那些煞車,在這裡要重新裝一次。
第 24 篇講過 FrugalGPT 的串接(cascade):先問便宜的模型,評分器判斷答案不夠可靠,才往上問貴的。路由的時機不一樣,它是在回答之前就看輸入、決定走哪一條。Building effective agents 舉的例子之一,就是簡單常見的問題送去 Claude Haiku 4.5 這類便宜的小模型,難的、少見的交給 Claude Sonnet 4.5 這類更強的模型。
兩者的帳不一樣:
| 面向 | 串接 | 路由 |
|---|---|---|
| 什麼時候決定 | 看過便宜模型的答案之後 | 看輸入的時候 |
| 每一題都多付的 | 評分那一步 | 分類那一次呼叫 |
| 難題另外多付的 | 便宜模型白答一次 | 不用 |
| 錯在哪 | 評分器把錯的答案當成夠好 | 分類器把難題分到小模型 |
分類那一次可以很便宜,但如果流程後面沒有再檢查,它分錯了,難題就直接被小模型答掉。另外第 24 篇那句話在這裡一樣成立:快取跟著模型走,分到不同模型的請求,各自是不同的前綴。
Claude 的 Managed Agents 文件裡有一個相關的用法,叫升級(escalation):一部分複雜的子任務,去問更強的代理或模型。另外它還能設一個顧問(advisor),主要的那個代理在一輪中途去問它策略,顧問只給建議、不接手(2026-10-09 查)。跟路由的差別在時間點:路由在入口就分好,這兩種是做到一半,由正在做事的代理自己決定要不要去問。
第 25 篇講的平行,接近 Building effective agents 說的切塊(sectioning):一件事拆成互不相依的幾塊,同時做。Building effective agents 還列了另一種,投票(voting):同一件事跑好幾次,拿多份輸出來比。
Li et al.(TMLR)的做法簡單到像作弊:同一個問題取樣好幾次,多數決。他們發現表現會隨著代理數量往上爬,進步多少看題目難度。Du et al.(2023)再多一步,讓幾個模型實例各自提出答案和推理,然後互相辯論,幾輪之後收斂到一個答案。摘要報告數學和策略推理都明顯變好,幻覺也變少,而且只要能呼叫模型就能做,不用碰權重。
但第 25 篇引過的 Wang et al.(2024)發現,提示詞寫好的單一代理,幾乎追得上最好的多代理討論,多代理只在提示詞裡沒有範例時才贏。投票和辯論的帳是 N 倍的呼叫,先確定單一代理已經寫到最好,再用 N 去換那一點把握。
辯論裡,每個實例都在提答案,也都在挑別人的毛病。第五種接法把這兩件事分給不同的角色:一個只寫,一個只評。
第 22 篇講過反思:Self-Refine 讓同一個模型替自己的輸出給回饋、反覆改,Reflexion 把反省寫成文字存起來。既然自己審得了,為什麼要另外開一個代理?
Huang et al.(ICLR 2024)看的是推理題上的內在自我修正:模型不靠任何外部回饋,只憑自己的能力改自己的答案。結果是它很難改對,有時候改完反而更差。
這跟 Self-Refine 的結果方向相反,Self-Refine 用的正是同一個模型給自己回饋,摘要報告七種任務(從對話回應到數學推理)平均進步約 20 個百分點。兩篇的任務和設定不同,我只讀了兩邊的摘要,說不出差在哪裡,所以不替它們調解。能確定的是 Reflexion 不一樣:它反省的材料是任務給的回饋訊號,不只是模型自己回頭看。自己審自己有沒有用,目前沒有一致的答案。
所以一個分開的審查者,要帶著寫的那一方沒有的東西才有用。至少有三樣:
git log 對照。但它跟第 24 篇的外部驗證不一樣:測試、schema、Stop hook 那支腳本不是模型,審查代理是。它可以去跑那些腳本,最後的判決還是一個模型下的。而因為第五種接法是一個環,它要有一個停得下來的條件。審的那一方可能永遠不說通過,寫的那一方可能改來改去在兩個版本之間擺盪。最少要有一個輪數上限,跟第 22 篇的 MAX_TURNS 是同一件事。
畫好的邊上,要傳東西。第 25 篇講過兩種大方向:交回給協調者,或寫到共用的地方。再往下一層,傳的東西有三種形狀:
| 面向 | 自由文字 | 結構化輸出 | 檔案 |
|---|---|---|---|
| 例子 | 子代理交回一段摘要 | {"verdict": "FAIL", "issues": [...]} |
寫到共用檔案系統的 changelog.md |
| 誰讀得懂 | 下一個模型 | 程式和模型都可以 | 誰都可以,自己去讀 |
| 掉了什麼 | 寫的人沒提到的細節 | schema 裡沒有欄位的東西 | 產物整份都在,但讀的人要自己找重點 |
| 下一步驗不驗得了 | 很難,只能再問一次模型 | 可以,程式直接判斷 | 可以,對著檔案跑檢查 |
放到寫和審之間,兩個方向該傳的不一樣:
if 決定要不要再繞一圈,不用再請模型讀一段評語、猜它算不算通過。走 API 的話,第 24 篇的 output_config.format 就能用 JSON Schema 把它固定下來。下面的實驗在 Claude Code 裡,只能在子代理的提示詞裡規定格式。Managed Agents 兩種都給得了:代理跟協調者之間傳訊息,同時共用一個檔案系統。寫的代理把檔案寫好,審的代理自己去讀,判決用訊息回給協調者。
上面五種接法要用哪一種、協調者能叫誰、邊上傳什麼,都是人決定的。研究在推的,是讓這些決定本身變成可以調、可以找的東西:
三篇的數字各自來自自己的評測,不能互相比大小。
產品裡,這張圖還是人畫的:你定義子代理、列名單、寫流程。這三篇把拆多細、怎麼接、整個流程長什麼樣子,都變成可以自動調整的東西。
用 Claude Code 的子代理把上面那套接起來。一個小 repo,五則 commit,其中一則帶 !,是破壞性變更:
feat: 匯出報表支援 CSV
fix: 登入逾時後沒有導回登入頁
chore: 升級 CI 的 Node 版本
feat!: /v1/orders 移除 page 參數,改用 cursor 分頁
docs: 修正 README 的安裝指令
規則有四條:
1. 分成「新功能」「修正」「內部」三類。文件(docs)與 CI、相依套件更新歸「內部」。
2. 只要有破壞性變更(commit 訊息的類型後面帶 `!`),最上面要有「## 破壞性變更」一節,寫出使用者要怎麼改。
3. 每一條結尾附 7 碼 commit hash,格式 `(abc1234)`。
4. 不能寫出 commit 訊息裡沒有的內容。
兩個子代理放在 .claude/agents/,寫的那一個用 Sonnet、可以寫檔,審的那一個用 Opus、只能讀,判決限定成一行 PASS,或 FAIL 加上「規則編號:問題」。主對話是協調者:先交給寫的那一個,交辦時只說要整理哪些 commit、存成 changelog.md,不給規則。寫完交給審的那一個,不是 PASS 就把問題清單原文轉回去改,最多三輪。整個過程走 token-inspectour(我自己寫的本機代理工具,第 23 篇用它攔過 Claude Code 的請求),每一個子代理的請求都攔得到。
我跑之前的預期:第一輪會被抓到規則 2 和 3,因為寫的那一方不知道有這兩條,第二輪通過。
第一版猜錯了,而且錯得很徹底。 規則我放在 repo 裡的 RULES.md,只在審查者的定義裡叫它去讀。跑兩次,兩次都是第一輪就 PASS。攔到的請求顯示,寫的那一方 ls 之後自己說了一句「There's a RULES.md; let me read it.」,就把規則讀了。交辦內容裡不給,擋不住它自己去讀檔,因為兩個子代理用的是同一個資料夾。第 25 篇說過子代理有自己的窗口,那是對話分開,檔案還是共用的。
第二版把規則移進審查者的定義檔,repo 裡不再有 RULES.md。這次寫的那一方沒去讀 .claude/ 底下的檔,同樣跑兩次(2026-10-10,Claude Code 2.1.296,主對話 Opus 5.5、effort medium,跑兩次是例子,不是證據):
| 第二版 | 輪數 | 每一輪的審查結果 | 費用(美元) | 時間 |
|---|---|---|---|---|
| 第 1 次 | 3 | 第 1 輪 FAIL 規則 1、2、3,第 2 輪 FAIL 規則 4,第 3 輪 PASS | 0.36 | 94 秒 |
| 第 2 次 | 2 | 第 1 輪 FAIL 規則 1、2、3,第 2 輪 FAIL 規則 2,協調者停下來 | 0.31 | 73 秒 |
第一輪兩次都一樣:分類多開了「文件」和「其他」(第 2 次叫「雜項」)兩節,破壞性變更的標題和位置不對,hash 用了半形括號。這三條比我猜的多一條。
第二輪開始,卡住的不是寫手。第 1 次,寫手照第一輪的意見補了 cursor 怎麼用,審查改判它違反規則 4,因為那是 commit 訊息裡沒有的東西,刪掉之後第三輪通過。第 2 次,審查直接說遷移方式「依規則 4 不能自己補,得先向作者要到遷移說明」,協調者沒有跑第三輪,停下來回頭問我 cursor 的參數叫什麼。規則 2 和規則 4 在這個 commit 上互相打架:commit 訊息沒寫遷移方式,寫了就違反 4,不寫就違反 2。這是我寫規則時沒看到的,兩個代理在來回裡把它找了出來。
兩次最後的破壞性變更一節,內容一模一樣,只有一句「/v1/orders 移除 page 參數,改用 cursor 分頁」。第 1 次的審查判它通過,第 2 次的審查判它違反規則 2。token-inspectour 裡,第 1 次的三輪審查,第一則請求都是 3,875 個詞元:協調者每一輪都開了一個新的審查子代理,它看不到自己上一輪說過「這一節也沒寫使用者要怎麼改」。
下面是 token-inspectour 攔到的審查者第一則請求(第 1 次的第一輪審查):
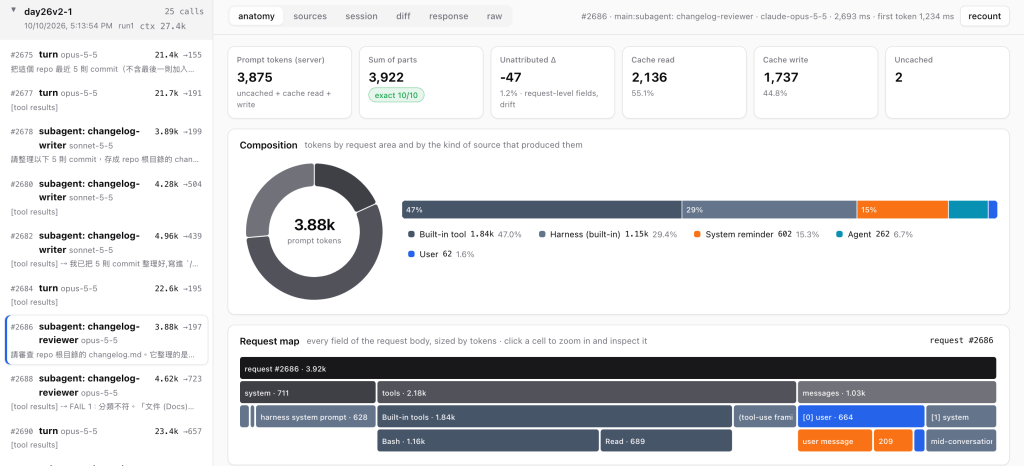
上面說審的那一方看不到寫的那一方想了什麼,這張圖看得出它拿到的是什麼。主代理寫給它的交辦只有 62 個詞元,含四條規則的代理定義是 262,剩下九成是 Claude Code 給每個子代理都會帶的東西:工具定義、harness 的系統提示,以及系統提醒。它沒有的,是主對話的內容:我給協調者的指示、寫手交回的報告,都不在這一則裡。第一版我把資料夾放在一個上層有 CLAUDE.md 的工作區裡,子代理的第一則請求連那份 CLAUDE.md 也一起收到了,所以實驗要放在乾淨的資料夾跑。
想自己重現的話,整套實驗放在 token-inspectour 的 examples/subagent-review,照裡面的 README 跑。rules-in-repo 是上面的第一版,rules-in-reviewer 是第二版。資料夾記得開在上層沒有 CLAUDE.md 的地方,不然子代理會連那份一起收到。
第一,每多一種接法,就多一個會錯或會貴的節點。 路由的分類器會分錯,投票要付 N 倍,協調者會切錯。
第二,寫審分開是一個環。 它要輪數上限,而上限到了還沒通過,你拿到的是一份沒過審的東西加一張問題清單,還是得有人看。
第三,審查者的標準就是品質的上限。 規則沒寫的,它不會抓。規則自己打架的,它會把你卡住。而且同一份內容,換一個審查者可能換一個判決。跟第 24 篇那支 Stop hook 一樣,標準寫多細,審查就有多細。
多了什麼能力:認得代理之間的五種接法,知道邊事先畫好還是臨場長出來、有沒有環,分得清路由和串接各在什麼時候決定、錯在哪裡,知道投票和辯論是平行的另一半,知道一個審查者要帶著乾淨的窗口、標準與工具、另一個模型才有用,並且會決定邊上該傳產物、判決還是摘要。
多付了什麼代價:每一個接點多一個會錯的地方、投票與寫審循環的倍數呼叫,以及一個只抓得到規則裡寫了的東西的審查者。
圖畫好了,要怎麼把它寫成程式?跑到一半斷掉要從哪裡接回來,人又要從哪裡插手?
論文
官方文件


 iThome鐵人賽
 看影片追技術